MMM 不是归因器

MMM 不是归因器:为什么你花几十万建的模型最后都进了抽屉

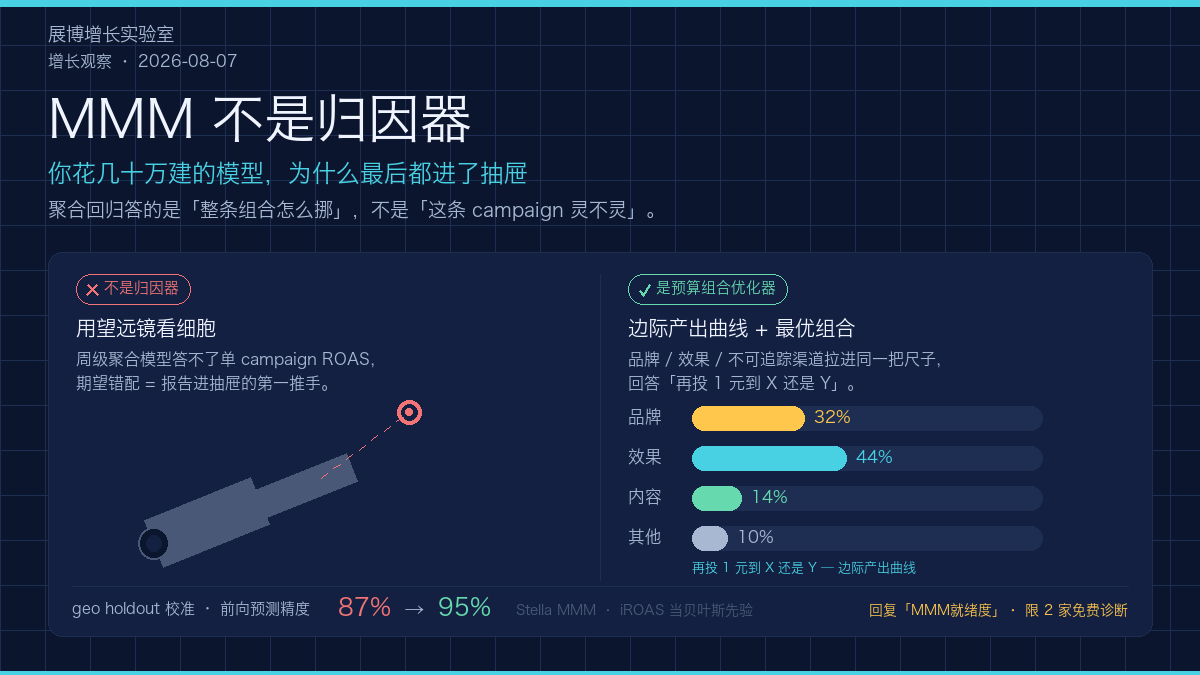
需求是"看清每笔预算",验收却是"这条 campaign 的 ROAS"——错配,是 MMM 项目死亡的第一推手。 作者:zhanbo · 2026-08-07 声明:本文为独立行业观察与通用测量方法论,基于公开资料整理,不代表任何雇主或客户观点;本工作室不承接游戏(含手游 / 休闲 / 中重度)行业相关咨询。 开篇:那笔进了抽屉的预算 “帮我看清每笔预算到底带来多少回报。” 这是几乎每个 CMO 找我时说的第一句话。同行(包括早年的我)下意识的反应都是:上 MMM(Marketing Mix Modeling,营销组合建模)。 三个月后,一份几十页的报告交付:边际 ROI 曲线、渠道贡献分解、最优预算分配建议。客户点头说"很有启发"。然后——报告进抽屉,预算照旧,明年再花几十万重做一遍。 这不是段子。这是过去十年营销分析行业最普遍的真实图景。MMM 项目交付率不低,采用率极低。 模型跑出来了,决策没发生。 问题不在模型,在我们用错了问题框。 一、五个典型死法:都死于同一类错配 把失败现象倒推,根因只有一类——期望与能力的错配。具体有五种姿势。 1. 期望错配(最大死因) 老板要的是"这条 campaign 的 ROAS 多少",MMM 给的是"品牌和效果整体怎么组合最优"。MMM 在周级聚合层跑回归,根本看不到单条 campaign。拿聚合模型去答用户级问题,等于拿望远镜看细胞——看不清,于是判"模型没用"。 2. 数据地基没打 建的是 spend(花费) 而非 impression(触达):MMM 的自变量应该是媒体权重,不是美元。CPM 一变,spend 和效果就错位,系数算反。 序列太短:稳健 MMM 要 104 周(两年)周级数据。很多团队跑 6 个月就建模,噪声吃掉信号。 共线性 / 无变异:所有渠道常年 always-on、同涨同跌、从不关停——模型在数学上无法识别各自系数,出来的数字纯靠先验,等于编。 3. 无校准(相关性当因果) MMM 系数是相关性。没有 geo holdout 实验当 ground truth,它就是"看起来科学的相关性幻觉"。Stella MMM 的基准很直白:未校准 MMM 前向预测精度 87%,用增量实验结果当贝叶斯先验回灌后到 95%——这 8 个点就是 CFO 信不信你的差别。 ...
2026年8月7日 · 2 分钟 · 341 字 · 展博
当 Agent 接管 80% 执行,顾问还卖什么

当 Agent 接管 80% 执行,顾问还卖什么?

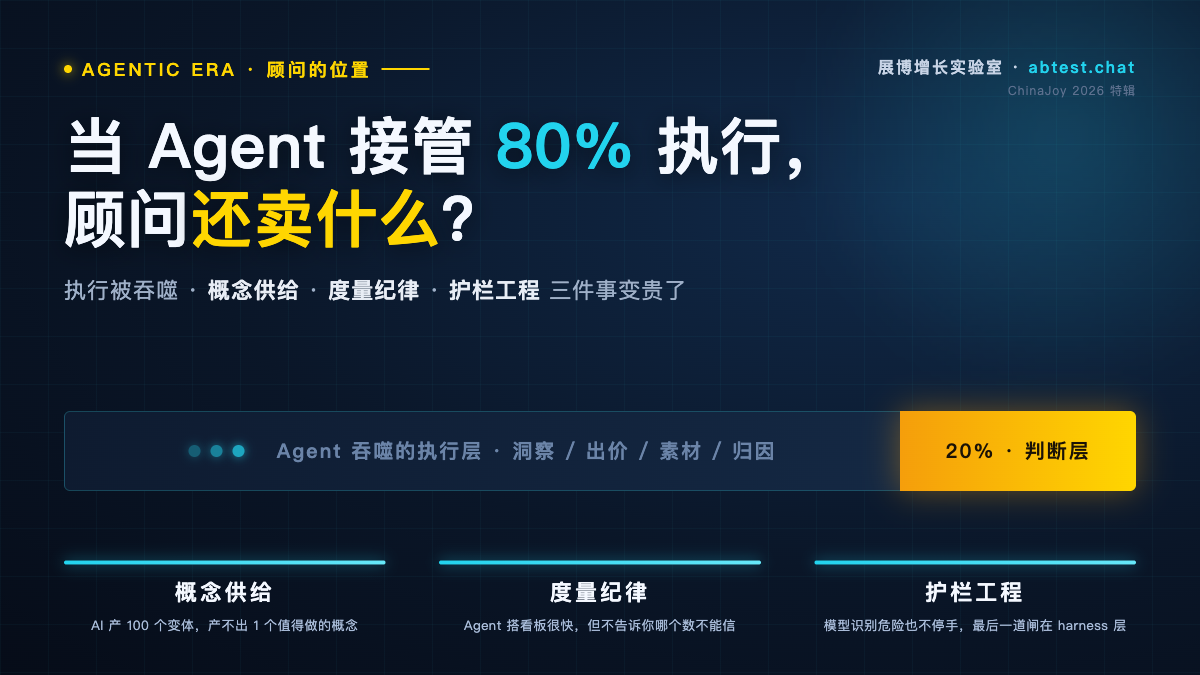
ChinaJoy 2026 刚闭幕。AgentOS 集中亮相,执行层正在被平台吞噬——但同时有三件事变贵了:概念供给、度量纪律、护栏工程。顾问的稀缺价值,恰好长在这三件事上。 作者:zhanbo · 2026-08-05 tl;dr ChinaJoy 2026 把一个事实摆到了台面上:Marvy 2.0 把 3 人 3 天的市场洞察压到 20 分钟 5 美元,Liftoff Cortex 每秒 10 亿次预测筛高价值用户——执行层正在被 Agent 平台化吞噬。 但执行被吞噬的同时,有三件事变贵了,而且是 Agent 自己解决不了的:概念供给、度量纪律、护栏工程。 这三件事,恰好是"专家指导层"顾问在 Agentic 时代卖的东西。不是卖执行、不是卖 SaaS、不是卖 prompt,是卖问题定义、卖度量纪律、卖护栏工程。 如果你正在建 Agent、买 Agent、或者被 Agent 替代焦虑困扰,这篇文章给你一个判断框架。 一、ChinaJoy 结束了,但留下一个被回避的问题 今年 ChinaJoy(7/31–8/3)最密集的信号不是新游戏,是一堆 AgentOS: 飞书深诺 Marvy 2.0:5 个智能体(市场洞察 / 数据分析 / 智能创意 / 媒介策略 / 智能投放),把传统 3 人 3 天的全球市场洞察报告压到 20 分钟、5 美元 Liftoff Cortex:神经网络每秒 10 亿次预测,围绕长留与付费筛高价值用户 游族:AI 素材参与度 70–80%,本地化翻译成本累计 -80% 全国首个游戏出海公共服务平台同期在上海上线 叠加 ChinaJoy 同一周的行业数据:Sensor Tower H1 报告显示,AppLovin MAX 与 AdMob 合计吃掉约 2/3 的游戏广告收入,全球下载量同比 -12%,CPI 却在持续走高。 ...

2026年8月5日 · 3 分钟 · 482 字 · 展博
Agentic UA 时代,Inhouse 是买方的最优解

UA 从微操进入策略和创意时代,Inhouse 是买方的最优解

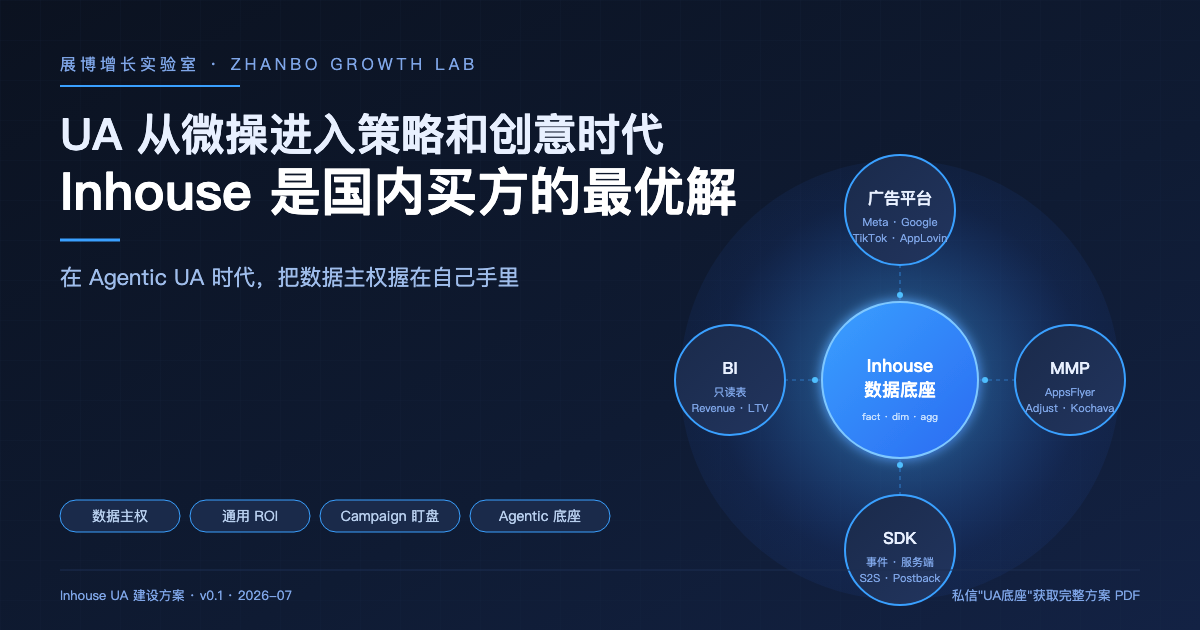
广告平台越来越"聪明",MMP 越做越深,代投模式被替代。UA 从微操进入策略和创意时代——买方需要一条自己的路,把数据主权握回自己手里。 作者:zhanbo · 2026-07-29 tl;dr UA 从微观操作时代进入了策略和创意时代:投手的手动优化空间越来越小,数据的主权归属却越来越重要。 三个正在发生的结构性变化——广告平台一键投放成默认、MMP 从归因工具向数据产品公司演化、代投/代理/SaaS 三种模式同时被冲击——共同把买方推向一个新的十字路口。 我的判断:Inhouse 是买方的最优解。理由有四:数据自主、数据深度应用、策略灵活性、AI 时代的复利。 我把这三重门槛的解法沉淀成了一套可交付方案——Inhouse UA 数据底座与 UA-Monitor 建设。8-12 周 Phase 1、12-24 周 Phase 2、24+ 周 Phase 3,分阶段推进,底座 own 在客户,不做 lock-in。 邮件 zanhe@139.com 或扫码加微信,主题写 “UA底座” 获取完整方案 PDF;主题写 “UA技术” 获取技术细节 Solution PDF。 开篇:一个正在被回避的问题 最近在跟几个出海投放团队的 CGO 和 UA Lead 聊天时,反复探讨同一个问题: “广告平台越来越聪明,Meta 上了 Advantage+、Google 上了 PMax、TikTok 上了 Smart+,我们投手每天在做什么?” 再深聊一层: “MMP 也越做越深,AppsFlyer 已经从归因平台变成一家数据产品公司,那我们自己的数据团队,还有什么价值?” 这两个问题的背后,是同一件事——UA 从微观操作时代进入了策略和创意时代。 而这件事对买方最直接的冲击是:投手的手动优化空间越来越小,数据的主权归属却越来越重要。 如果这一步走错,接下来 12-24 个月,你会失去两样东西:议价权 和 数据资产。 一、三个正在发生的结构性变化 变化 1:广告平台一键投放能力成为默认 数一下这半年的产品动作: ...

2026年7月29日 · 4 分钟 · 704 字 · 展博
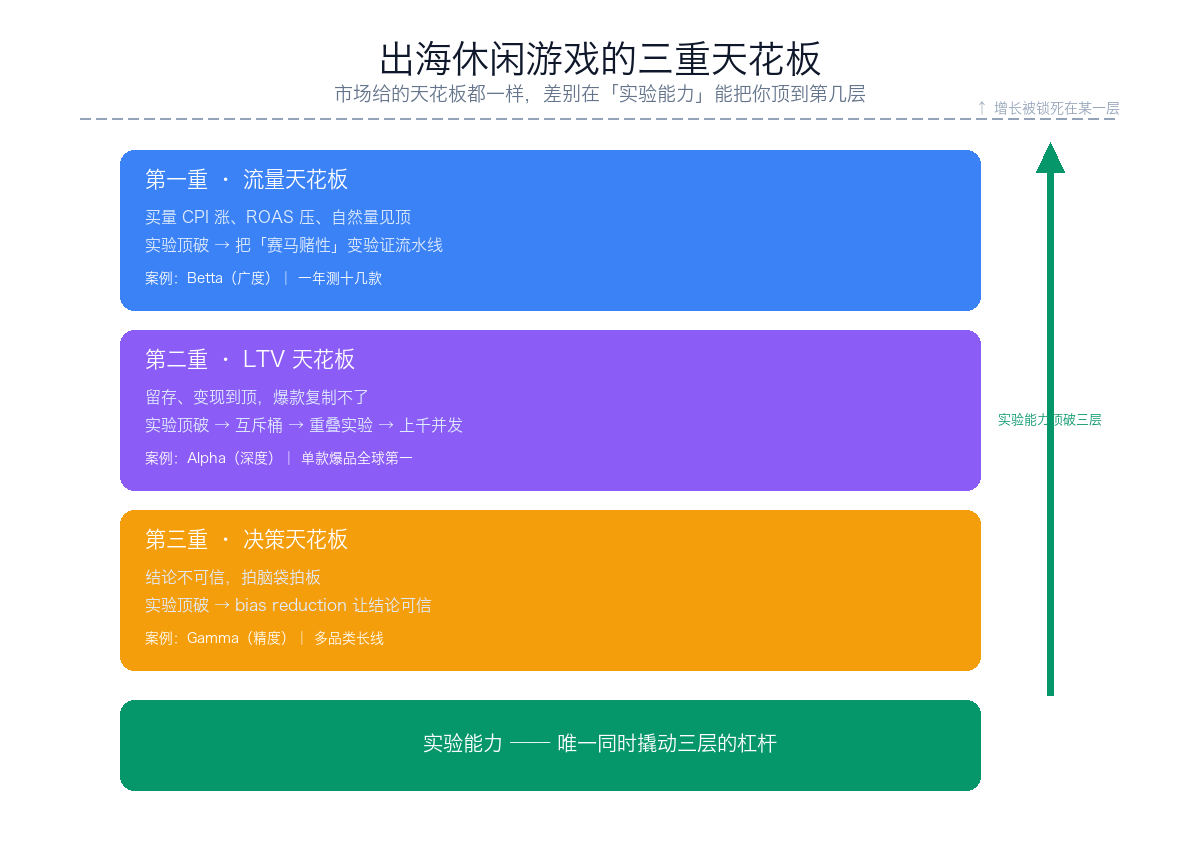
三个 Studio,三种实验红利:广度、深度、精度

三个 Studio,三种实验红利:广度、深度、精度对应的三类增长瓶颈

三个 Studio 的实验复盘:广度、深度、精度,对应三类增长瓶颈——以及你怎么拿到同样的增长红利。 作者:zhanbo · 2026-07-15 tl;dr 我近距离参与过三个出海 Studio 的实验平台建设,他们从实验里拿到的,不是某一次优化,是把不确定性变成可复利增长的组织能力。 广度、深度、精度——三种实验红利对应三类增长瓶颈:验证太慢、流量不够、结论不可信。 如果你正卡在实验平台建设、或者跑了实验却拿不到真实增长,可以邮件 zanhe@139.com 交流,主题写"实验红利"。 一、连续两年全球下载第一,靠的不是运气 一款 2022 年上线的方块消除游戏,2024、2025 连续两年拿下全球手游下载榜第一,2025 年一年下载 3.68 亿次,累计超 8 亿,月活过 3 亿。纯靠应用内广告变现,月流水千万美元级。 它的开发商对媒体只说过一句很朴素的话:任何要改动的地方,都会先做 A/B 测试,确认不会伤到这个庞大的用户盘,才真正上线。(数据来源:AppMagic / mobilegamer 2025 年度下载榜) 连续两年第一,不可能是运气。运气不会重复。能重复的,是一套把"改一下试试"变成"可信决策"的机制。 这几年我近距离参与过三个出海 Studio 的实验能力建设,从平台选型一直到交付落地。今天把这三段复盘摊开,讲一件事:这些团队从实验里,到底拿到了什么。 (下面三个案例都做了脱敏,用 Alpha / Beta / Gamma 代号。) 二、三个 Studio,三种实验红利 Beta:广度——把"赛马"变成一条验证流水线。 Beta 是一家老牌出海厂,打法是海量试新,一年能测十几款产品,每隔两三个月出一款新品。这种打法对实验能力的要求不是"深",是"快而准"——能不能用最小成本判断一个玩法、一个买量素材、一个变现节奏值不值得加码。我参与了他们的实验平台选型,帮他们先想清楚"这平台到底要解决哪类验证"。对这种 Studio,实验红利是广度:把老板拍脑袋的赛马,变成一条标准化、可复用的验证流水线。 Alpha:深度——一款爆品,靠上千并发实验持续打磨。 Alpha 是另一个极端:不铺量,就一款产品,但要把它打磨到全球第一。最初也买了第三方 SaaS,后来因为实验参数和发版耦合太重、成本高,转向内部自建——但自建的分流只做到互斥桶,实验一多就撞车,流量根本不够分。我是后面作为顾问介入的,帮他们把流量框架从互斥桶升级到重叠实验,把并发顶到上千个实验同时跑,产品、算法、商业化实验并行。对这种 Studio,实验红利是深度:同样的流量,能验证的假设多了一个数量级。 Gamma:精度——从"能跑实验"到"实验结论可信"。 Gamma 是一家多品类的长线厂,数独、填色、麻将、拼图,每个细分都做到头部,靠的是长期稳定的迭代。我参与过他们实验平台的几次演进:2019 年那版 1.0 解决的是"分析方法",把实验数据算对;到 2021 年,讨论的核心已经变成 bias reduction——怎么把选择偏差、幸存者偏差、偷看数据这些让结论失真的东西剔掉。对这种 Studio,实验红利是精度:当你一年要做几百个实验,哪怕只有 0.5% 的假阳性,也够让你全量上线一堆其实没用的改动。 三、他们到底从实验里拿到了什么 把三段拼起来,答案就清楚了。他们拿到的从来不是"某一次优化涨了多少",是三样更底层的东西。 ...

2026年7月15日 · 1 分钟 · 166 字 · 展博
选型与交付:咨询顾问的价值定位

一个止于选型,一个补上交付:两个项目复盘以及咨询顾问的价值定位

选对平台,只解决了"用什么";完成交付,才能回答"有没有拿到业务结果"。顾问不跟 SaaS 抢生意,也不跟技术团队抢活——在采购、自建、交付、拿结果的全过程里,提供专家经验和指引。 作者:zhanbo · 2026-07-13 tl;dr 两个 Studio 都采购过火山引擎 ABTester:一个项目我参与到选型,一个项目我补上了后续交付。它们恰好说明,顾问的价值不在于"卖平台"或"替研发写代码",而在选型和交付两端提供专家指引,把工具转化为业务结果。 我推出了「实验平台落地诊断」和「发行平台提效诊断」,本季度限 2 家。邮件 zanhe@139.com 或扫码加微信,主题写"实验落地"或"发行提效",帮你判断采购、自建、交付这条链上,专家经验应该补在哪一段。 两个 Studio,两种参与方式 2025 年,我先后接触了两个团队的实验能力建设项目。为保护客户信息,本文分别称其为 Beta Studio 和 Alpha Studio。 Beta:研发资源有限,选择 SaaS 快速起步 2025 年中,Beta 希望升级实验能力。 当时业务部门有明确需求,但缺少足够的专项研发资源。在内部自建与采购 SaaS 之间,团队最终选择了火山引擎 ABTester,希望借助成熟产品更快建立实验能力。厂商的行业影响力和已有案例,也是选型的重要因素。 我参与了前期咨询和选型讨论,但没有继续跟进后续交付,因此无法评价项目最终效果。 这段经历留下的核心问题是: 买到平台,只是确定了实验能力的技术载体,并不代表企业已经获得了实验能力。 选型结束后,仍有一系列问题需要解决: 业务数据和实验参数如何接入; 参数配置是否依赖软件版本发布; 指标口径和验收标准如何定义; 流量框架是否适合实际业务; 谁负责平台运营和实验复盘; 实验结论如何进入业务决策。 这些问题不会随着合同签署自动解决。 Alpha:有了自建分流,为什么仍然跑不快? Alpha 在 2024 年上半年也采购了火山引擎 ABTester。由于实验参数与软件发版耦合较重,团队随后自建了分流能力。 但第一版只支持互斥桶。 互斥桶可以避免实验冲突,却会把流量切割成相互独立的区域。随着实验数量增加,可用流量很快成为瓶颈。平台虽然"能跑实验",却难以支持产品、算法和商业化团队同时开展大量实验。 我是在这个阶段作为顾问参与项目的。 后续迭代中,团队引入了类似 Google 重叠实验基础设施的分层、分域和正交流量框架。只要实验修改的参数和影响范围不同,就可以在控制冲突的前提下共享流量。 升级之后,平台能够支持上千量级的实验并发,产品交互、算法和商业化实验得以大规模并行,并最终明显推动了北极星指标。 真正产生价值的不是"并发数字"本身,而是团队建立了一条完整链路: 业务假设 → 实验配置 → 并行验证 → 指标分析 → 上线或回滚 → 收益追踪 ...

2026年7月13日 · 2 分钟 · 214 字 · 展博
AD Agent 4 天迭代实录

AD Agent 开发实录和版本迭代——4 天从两个 Skill 到一个能自治的投放大脑

优化师效率和买量 ROI,这两条曲线,能不能被一个 agent 同时拉起来? 作者:zhanbo · 2026-07-11 声明:本文为个人业余时间的独立技术实践与方法论记录,全部代码、Skill、Prompt 均基于公开资料与个人环境搭建,不涉及任何雇主或客户的内部系统、数据、账户或商业秘密;本工作室不承接游戏(含手游 / 休闲 / 中重度)行业相关咨询。 tl;dr 4 天从 0 到能自治的 ad-agent,我在 changelog 里写了 7 个版本、5 个 Phase——顺序对了才是工具,顺序错了都是 demo。 大多数团队卡在"要不要接大模型",其实真正卡的地方根本不在模型——关键是你的问题,你给模型准备了哪些数据以及策略迭代的领域知识。 本文附 5 道 ad-agent 就绪度自测 + 一份 90 天路线图诊断(限 2 家)。 一、问题先行:优化师的一天,值不值得被 agent 接管 先说业务,再说 agent,不然一切都是空的。 获客投放团队里,优化师的日常长这样: 早上打开 Meta / Google / TikTok 三个后台,各抄一遍昨日 spend / installs / ROAS 打开归因平台(AppsFlyer / Adjust)再抄一遍 D1 / D7 ROI 打开 BI 或飞书表格核对,发现三份数据对不上——花半小时找 last-touch 和 incremental 的口径 中午看到某个 campaign CPI 飙了 30%,猜是素材疲劳还是竞价对手加价,打开素材库比对创意 下午调预算、换素材、跑 A/B——每一步都要在三个平台重复操作一次 一个团队 20 个 campaign 就够把一个优化师钉死在屏幕前。所以 ad-agent 不是一个"AI 概念题",它要解决的是四件很土的事: ...

2026年7月11日 · 4 分钟 · 796 字 · 展博
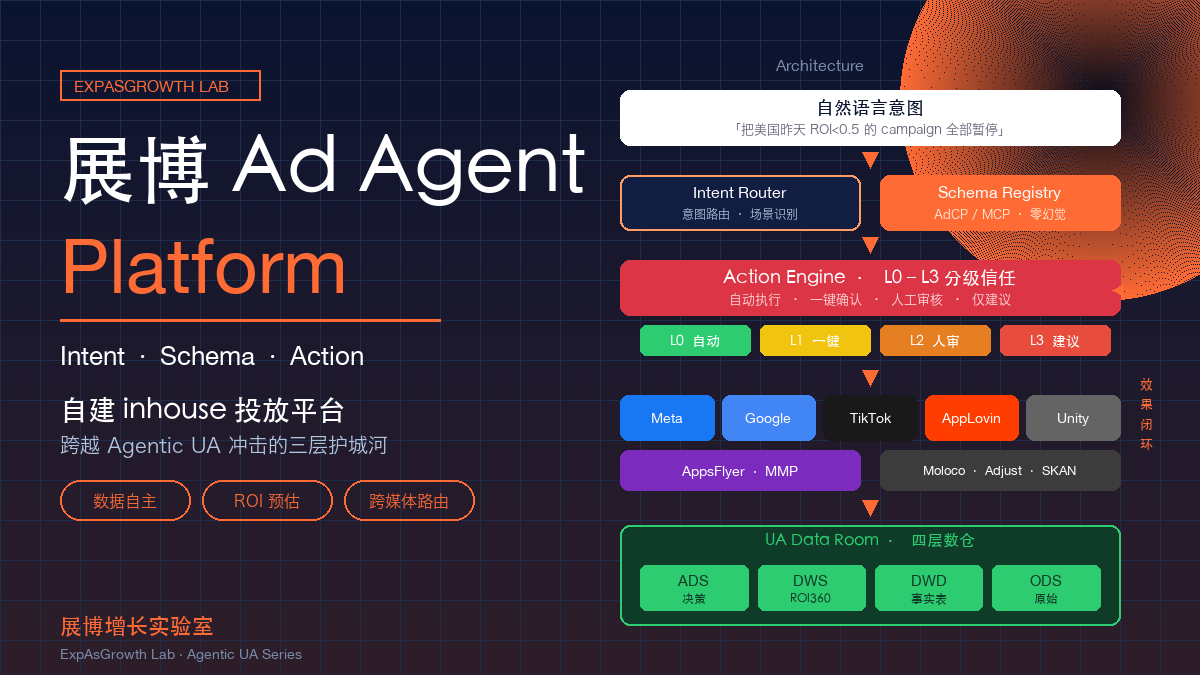
展博 Ad Agent Platform 架构封面

从钛动招股书看 Agentic UA 时代的三种终局——代投、SaaS、inhouse

钛动科技递表港交所,82% 毛利率、38 亿应收账款、代投占绝大部分收入。这套模型在 Agentic UA 时代还站得住脚吗? 作者:展博 / 2026-07-04 声明:本文为独立行业观察,基于公开招股书与公开报道整理,不代表任何雇主或客户观点,不构成投资建议;本工作室不承接游戏(含手游 / 休闲 / 中重度)行业相关咨询,行业分析仅作为方法论示例。 tl;dr 82% 毛利率不是 AI 溢价,是会计口径:钛动的毛利率不能对标 Salesforce,它用净额法把媒体成本从营收里扣掉,剩下的"服务费"计为营收。研发投入占比不到 10%,员工里大量是优化师,本质仍是高杠杆的代投公司。 代理生态是媒体让渡的生存空间:Meta / Google / TikTok 给到代理商的返点、垫资额度、独家版位,是媒体在特定阶段的"分销红利"。这个空间正在被 Agentic UA 一步步收回。 代投模式会被 PMax / Advantage+ / Smart+ 逐级替代:广告主只需要给"预算 + 创意 + 转化信号",campaign 结构、出价、版位、受众全交给媒体算法。代投团队"搭 campaign / 调出价"的核心工作量,正在归零。 国内买家的 SaaS 接受度天然低:数据无法联通、inhouse 数据不外流、决策链条深、ROI 无法证明——TTD 那套海外投放平台生态在国内跑不通,钛动/GatherOne/飞书深诺的 SaaS 收入占比大概率不到 10%。 inhouse 自建才是国内出海买量的终局:数据自主 + ROI 预估模型 + 跨媒体灵活路由,这三件事只能自己做。代投+SaaS 双轮驱动的故事,写在招股书里好看,但打不过一个中等规模品牌自建的发行平台。 一、先拆一下钛动这张财报 钛动 2026 年 2 月递表港交所,中金 + 摩根大通保荐。招股书里最抓眼球的数字是82% 毛利率。 ...

2026年7月4日 · 6 分钟 · 1230 字 · 展博

竞对靠实验跑出了增长,为什么我们不行?

同样在做 AB 测试,别人靠它持续迭代、增长一路向上,我们的实验却结果不可靠、推全就反转。问题往往不在平台,而在你没建之前就该想清楚的那几件事。 作者:展博 / 2026-06-22 tl;dr 竞对靠实验跑赢了,你也想做,但「实验结果不可靠、推全后效果反转、不知道该信哪个指标」——这些不是平台不够强,是实验体系没建对。 实验时涨、推全后反转,最常见的原因有三个:偷看数据提前停、只挑显著指标报、没看护栏指标。这三个坑和平台贵不贵没关系。 判断一个提升是否可信,不能只看 p<0.05,还要看效应量、护栏指标有没有掉、长期效应是否成立。 80% 的实验平台问题不是技术问题,是指标口径、流程、组织问题。 你以为缺的是工具,其实缺的是共识。 建平台之前,先花半天做个体检。 决策前花小钱搞清楚「值不值得建、该怎么建」,比拍脑袋投几十万、再发现方向错了,便宜太多。 一、你可能正被这几个问题困住 先不谈平台、不谈架构。我想先问你几个问题——如果你是增长、产品或者数据负责人,看看下面这些是不是你正在经历的: 「竞对靠实验跑出来了,我们也想做实验,但不知道从哪儿下手。」 看到对手用 AB 测试快速迭代、增长曲线一路上扬,你也想复制这套打法,可一落到自己团队,连「第一个实验该怎么设计」都说不清楚。 「我们的实验平台,结果好像不太可靠。」 平台是有了,可同一个实验,不同人看出来的结论不一样;今天说显著,明天又说不显著。你心里其实没底——这些数到底能不能信? 「实验时看着涨,推全之后效果反转,或者根本没达到预期。」 这是最让人崩溃的一种。实验阶段明明指标涨了,信心满满全量上线,结果线上效果反转,甚至还不如不改。那当初那个「提升」,到底是真的,还是数据骗了你? 「到底该看哪些指标?怎么判断一个提升是不是可信?」 一个实验看十几个指标,挑一个涨的报上去,算不算成功?p 值小于 0.05 就一定靠谱吗?留存没动、付费涨了,能推全吗? 「说到底——我们的实验平台,建得到底对不对?」 花了钱、花了人,可越用越怀疑:是不是从一开始方向就错了? 如果这些问题你中了一半以上,那我可以负责任地说:这些大概率不是「平台不够强」的问题,而是「实验体系没建对」的问题。 而后者,加再多机器、买再贵的 SaaS 也解决不了。 下面我们一个一个拆。 二、一个真实的场景:平台建好了,然后呢? 先说一个我反复见到的场景,它正是上面那些问题的总和。 一家公司,老板拍板「我们要数据驱动」,于是数据团队花了三个月,搭了一个看起来很专业的实验平台:能分流、能看报表、能跑 AB。 然后呢? 产品团队觉得「这玩意儿太麻烦,我直接上线不行吗」; 增长团队自己有一套买量看数的逻辑,不鸟这个平台; 数据团队辛辛苦苦建的东西,三个月后没人用,结论也没人信。 钱花了,平台有了,但增长没变快。 这不是个例。根据我的观察,有实验平台的团队里,大概 80% 都卡在「建了但没人用」这个状态。 更要命的是,这个坑很贵——你不是损失了搭平台的几十万,你损失的是「本可以用来验证增长假设的几个月时间」。 三、为什么会这样?因为大部分问题,根本不是技术问题 很多团队一想到「实验能力不行」,第一反应是「我们的工具不行,得建个更好的平台」。 这是最常见的误判。 先说结论:实验体系的问题,可以拆成四层,技术只是最浅的一层。 阻力层 典型表现 真相 工具层 「我们没有实验平台」「分流都做不了」 这是最容易解决的,花钱花人就能搞定 流程层 「实验做完就忘了」「没人写假设」「结论存哪了?」 工具再好,流程不通照样白搭 组织层 「数据团队建平台,产品团队不用,增长团队自己玩」 三权不清,谁都不为实验结果负责 文化层 「老板拍板,实验数据不算数」「失败的实验没人敢说」 最深的一层,建再好的平台也救不了 这里最关键的是:很多你以为的「技术问题」,其实是流程或组织问题。 ...

2026年6月22日 · 1 分钟 · 207 字 · 展博

Meta 商业化大变革:从 Marketing API 到 Agentic Ads——未来的广告买量是 A2A 架构

从 Meta 广告平台的 20 年演进,看 Marketing API 为什么从 v1 一路走到 v25,以及广告主侧的 Ad Agent 为什么会越来越重要。 声明:本文为独立行业观察,基于公开资料整理,不代表任何雇主或客户观点;本工作室不承接游戏(含手游 / 休闲 / 中重度)行业相关咨询。 tl;dr Meta 广告系统的演进,不是一条简单的"广告后台功能越来越多"的产品线,而是一条更清晰的主线:从人工投放,到算法托管,再到 Agentic execution,工具->平台->操作系统的迁移路线很清晰。 Marketing API 的版本迭代也不是纯技术问题。v1 到 v25 的变化,本质是 Meta 把广告系统的控制权,从广告主和第三方工具手里,逐步迁移到自己的算法和自动化系统里。 这件事对广告主很关键:未来不是工具层的"谁更会点后台",也不是平台层的"做聚合投放",而是谁能搭建一个本地的、跨平台的、可审计的 Ad Agent,把 Meta / Google / TikTok 的自动化能力策略性地聚合到自己的增长操作系统里。 一、Meta 商业化的 20 年:广告平台如何从工具变成操作系统 先说结论:Meta 商业化的历史,就是广告主控制权不断让渡给平台算法的历史。 早期 Facebook Ads 是一个广告工具。你选人群、选版位、写素材、设预算,平台负责把广告投出去。 今天的 Meta Ads 更像一个黑盒增长系统。广告主提供目标、素材、预算、转化信号,剩下的受众匹配、版位组合、预算分配、创意组合,越来越多由系统自动完成。 可以粗略分成五个阶段。 阶段 1:社交广告的诞生——把"人"变成广告库存 Facebook 广告的第一阶段,是把社交关系和用户画像商业化。 传统展示广告卖的是页面位置。Facebook 卖的是人:年龄、性别、兴趣、关系、行为。 这带来一个根本变化:广告投放从"买媒体位置"变成"买用户匹配"。 传统 display ads: 广告主 → 买网站/频道/版位 → 触达用户 Facebook Ads: 广告主 → 定义人群/目标 → 系统匹配用户 这个阶段的核心能力是 targeting。 ...

2026年6月1日 · 6 分钟 · 1161 字 · 展博

企业 AI Agent 落地指南:跨越从模型到业务的 7 层漏斗

2026 年 5 月 作者:展博 引言:为什么最强的模型,交付效果却不如人意? 2026 年,AI Agent 已经不是新鲜词。 企业 CTO 们纷纷入局:买 GPU、接 GPT-5、搭 LangChain、招 AI 工程师。但半年下来,真正产生业务价值的案例寥寥无几。 一个真实的对话: CEO:“我们投了 200 万做 AI,为什么 ROI 没提升?” CTO:“模型效果很好啊,GPT-5 的 benchmark 都是 SOTA…” CEO:“我要的是广告投放 ROI 提升 20%,不是 benchmark 第一。” 这个问题,几乎每个做 AI 转型的企业都会遇到。 核心矛盾:模型能力 ≠ 业务结果。 从最强的模型到最终的业务指标(ROI、用户体验、商业化变现),中间隔着至少 7 层漏斗。任何一层的缺失或薄弱,都会导致"叫好不叫座"。 本文将用 Ad Agent(广告投放智能体) 作为实战案例,系统讲解: AI 应用交付的 7 层漏斗模型(自顶向下设计方法) 技术选型:LangGraph vs 自研 vs Claude Code? 实施路径:从 Skill 验证到生产系统(含代码示例) 不同规模企业的最佳实践(<10 人 → 500 人) 一、AI 应用交付的 7 层漏斗 1.1 漏斗模型:最强的模型 ≠ 最好的业务结果 ┌─────────────────────────────────────────────────────────────────┐ │ L1 业务指标层 最顶层:ROI、用户体验、商业化变现 │ │ ↓(很多团队在这里就断了) │ │ L2 业务抽象层 基于指标定义场景和工作流 │ │ ↓ │ │ L3 应用设计层 基于编排的应用层,监控/审核/存储等 │ │ ↓ │ │ L4 流程编排层 Human-in-the-loop,人/模型/系统协调联动 │ │ ↓ │ │ L5 上下文工程层 高质量输入 → 高质量输出(Harness 工程) │ │ ↓ │ │ L6 模型调用层 合理调度模型,避免大材小用或力不从心 │ │ ↓ │ │ L7 模型能力层 最底层:模型本身的推理、理解、生成能力 │ └─────────────────────────────────────────────────────────────────┘ 关键洞察: ...

2026年5月29日 · 14 分钟 · 2915 字 · 展博