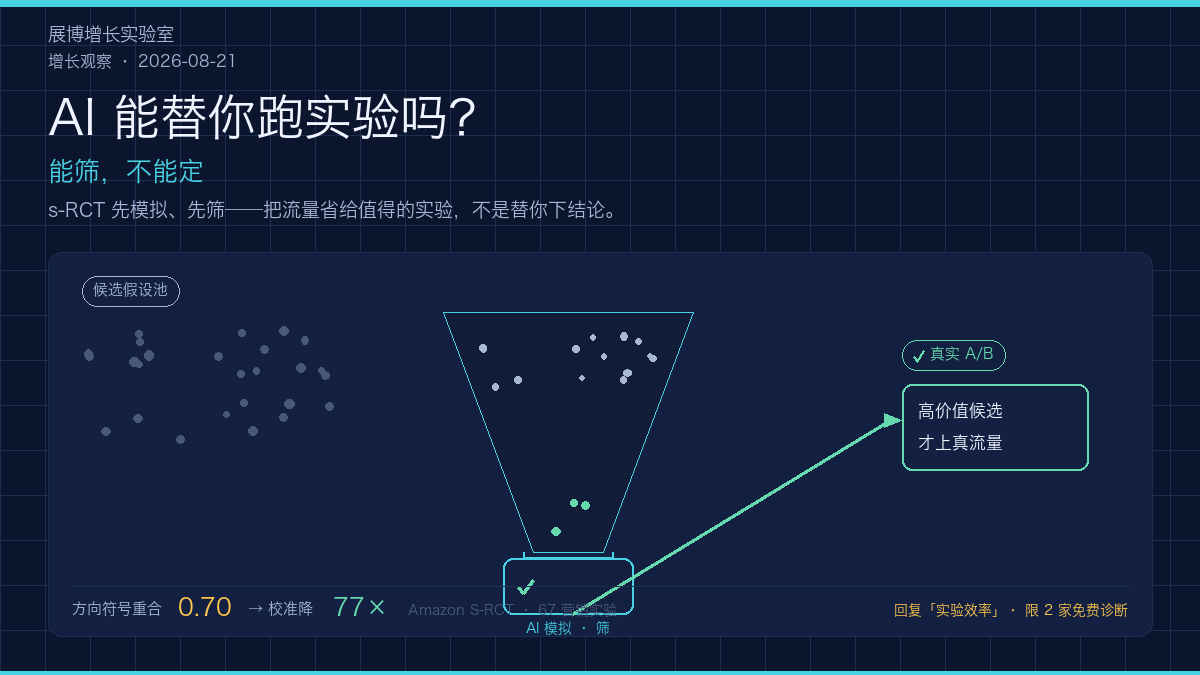
副标题:从 RCT 到 s-RCT:把实验从「省着跑」变成「跑得值」
作者:zhanbo · 2026-08-21
声明:本文为独立行业观察,基于公开资料整理,不代表任何雇主或客户观点;本工作室不承接游戏(含手游 / 休闲 / 中重度)行业相关咨询。
tl;dr(3 条)
- 每个实验都有流量和时间成本,但是实验成功率却越来越低——s-RCT 用 AI agent 先模拟、先筛,把流量省给值得的实验。
- Amazon 论文的实证:agent 模拟的原始方向信号偏弱(符号重合 0.70 没明显超过无信息基线),校准后才把误差降 77×——能筛,不能定。
- 实验效率的第一步不是换工具,是检查你的漏斗:历史实验库有没有、AI 会不会泛化假设、拟合指标建没建(回复「实验效率」拿诊断)。
一、开题:AI 能替我跑实验吗
「AI 能替我跑实验吗?」
增长团队最近被问得最多的,就是这个问题。
问的人手里通常攒着一叠实验报告:有的没跑完就被砍,有的跑完了结论是「无显著差异」。真正变成决策的,一个季度下来数得过来。
不是团队不努力。是实验这件事本身在变贵——每个实验都要真实流量、要排期、要工程师陪跑,而这些成本,一半花在了注定没结论的实验上。
另一面,想法的供给在爆炸。以前一周想三个实验,现在 AI 一天能给你三十个。流量和工期没变,候选池却大了十倍,实验成功率自然被稀释。这不是哪家公司的管理问题,是整个行业的漏斗问题。
二、从 RCT 到 s-RCT:效率的漏斗
实验效率的瓶颈,已经从「能不能跑」变成了「值不值得跑」。
过去十年,我们把 RCT 当作金标准:随机分组、真实流量、统计显著,一切都对。但金标准的前提是流量够、工期够、候选少。当候选变多、流量变贵,金标准就变成了奢侈品——不是不该用,是没那么多预算给每个想法都用一遍。
s-RCT(Simulated RCT,模拟随机对照试验)就是冲这个错配来的。Amazon 的两位研究者(Stefan Hut、Lorenzo Masoero,8/13 更新论文)提出:让 AI agent 拿着用户的「行为画像」和「干预描述」,在投入真实流量之前,先模拟一遍 A/B 结果,把明显没戏的候选筛掉。
把流程拆成四段:
历史实验库沉淀 → AI 泛化出假设 → AI 收敛掉弱候选 → 高价值的进真实 A/B
前两段是「库」和「生成」:历史实验库沉淀每次实验的结论,AI 从里面学模式、批量泛化出新假设。第三段是 s-RCT 的主场:agent 模拟结果,做候选的收敛和排序。第四段,只有排在前面的高价值候选,才拿到真实流量跑 RCT。
论文在 67 个电商产品页的营销创意 A/B 测试上做回测(横幅、文案、图片变体,指标是点击率)。结果比较克制:现成基础模型做引擎,符号重合 0.70——但论文自己指出,这没明显超过「全预测为正」这类无信息基线;两阶段校准后,预测误差才降约 77 倍(16 个实验子集上);被试内设计(同一个 agent 同时看两组),标准误再降 2.4 倍。
这是效率账:不是多跑实验,是少跑废实验。流量还是那些,但每一份都花在更值得的实验上。
还有一个好消息:s-RCT 不挑引擎。论文强调框架与 agent 无关——无论是微调过的专家模型,还是现成的通用基础模型,都能当模拟引擎。小团队不需要自建大模型,用现成 API 就能先跑起来,门槛没有想象中高。
三、不是万能,是提效
但我建议先把期待压下来。
s-RCT 有两个硬边界,写论文的人自己都标了。
第一,它的方向信号比想象中弱。论文作者自己提醒:0.70 的符号重合并没有明显超过「全预测为正」这种最笨的基线,上线对齐 0.41 接近随机。论文用的设计叫 agentic-twin——每个 agent 一对一绑定一个参与过实验的真实客户,拿他的行为画像去模拟「会不会点击」——但画像抓不住用户当下的意图和心情,误差消不掉。所以原始 agent 模拟更像「有点参考价值但不稳」,校准和人工兜底才是能用的前提。它能辅助压缩候选集、省真实流量,但替代不了真实验证。
第二,它准不准,取决于 agent 是不是真的模拟了你的用户。论文的验证在商业营销域,换到别的领域,行为画像要重建——留存曲线、付费习惯、会话结构,都得换成你自己用户的数据。
这跟强化学习训练机器人是同一个问题。仿真环境里练出来的策略,拿到现实世界会有 sim-to-real gap,所以要有「拟合判断指标」来判断模拟器靠不靠谱。s-RCT 也一样,至少三组指标:行为分布对不对得上、方向预测准不准、幅度偏多少。指标不过关,模拟器就是自嗨。
电商能用,游戏也能复用框架,但别把论文的数字直接搬过去。画像、指标、校准,都得在自己的历史实验库上重新验一遍。
怎么落地?不用一步到位,三件事先做:第一,把过去一年的实验结论结构化成库,哪怕先是一张表;第二,拿 AI 对库里的历史假设做一次泛化和收敛,看看它筛出来的候选和真实验结果对不对得上;第三,给模拟器建一组拟合指标,跑几轮校准。这三步做完,实验漏斗就能开始省流量了。
一句话:AI 是帮你省流量的筛子,不是替你下结论的裁判。
四、落地:先看清漏斗漏在哪
实验效率的第一步,不是换工具,是看清漏斗在哪一环漏。
你的历史实验库,有没有在沉淀?你的假设,是 AI 泛化出来的,还是拍脑袋?你的模拟候选,过拟合指标验证了吗?
我见过的增长团队里,三个「没有」占两个以上的不少——这个免费诊断,就是给他们的。
3 分钟自测(Yes/No)
- 过去一个季度,有几个实验是「跑了但没结论」的?
- 你有一个结构化的历史实验库,还是靠人脑记?
- 新实验想法,是系统批量生成的,还是一个一个冒出来的?
- 你知道自己的模拟/预测工具,方向正确率和幅度偏差是多少吗?
- 你的实验漏斗,哪一环在烧最多的流量和时间?(答不上来 = 问题所在)
免费 · 实验效率诊断(限 2 家 · 本月底)
- 只诊断不动手,14 天交付,适合有实验团队但成功率在下降的成长型业务。
- 公众号后台回复关键词 「实验效率」 + 一句你的增长现状,先到先得。
延伸阅读
- S-RCT 论文(Amazon,arXiv 2608.02345) — 双层误差分解 + 校准协议原文
- 归因框架:业务方可自证的科学决策体系 — s-RCT 的「模拟 + 校准」是增量验证的前置环节
- MMM 不是归因器 — 同类问题:工具不万能,就绪度才是门槛