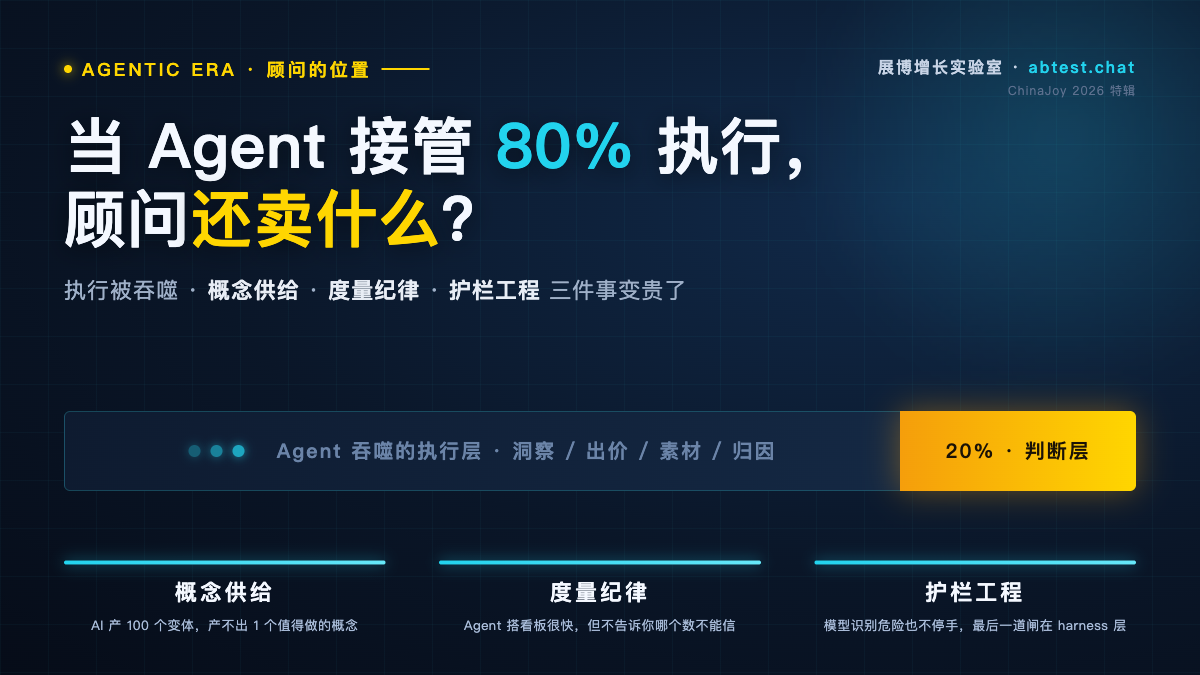
ChinaJoy 2026 刚闭幕。AgentOS 集中亮相,执行层正在被平台吞噬——但同时有三件事变贵了:概念供给、度量纪律、护栏工程。顾问的稀缺价值,恰好长在这三件事上。
作者:zhanbo · 2026-08-05
tl;dr
- ChinaJoy 2026 把一个事实摆到了台面上:Marvy 2.0 把 3 人 3 天的市场洞察压到 20 分钟 5 美元,Liftoff Cortex 每秒 10 亿次预测筛高价值用户——执行层正在被 Agent 平台化吞噬。
- 但执行被吞噬的同时,有三件事变贵了,而且是 Agent 自己解决不了的:概念供给、度量纪律、护栏工程。
- 这三件事,恰好是"专家指导层"顾问在 Agentic 时代卖的东西。不是卖执行、不是卖 SaaS、不是卖 prompt,是卖问题定义、卖度量纪律、卖护栏工程。
- 如果你正在建 Agent、买 Agent、或者被 Agent 替代焦虑困扰,这篇文章给你一个判断框架。
一、ChinaJoy 结束了,但留下一个被回避的问题
今年 ChinaJoy(7/31–8/3)最密集的信号不是新游戏,是一堆 AgentOS:
- 飞书深诺 Marvy 2.0:5 个智能体(市场洞察 / 数据分析 / 智能创意 / 媒介策略 / 智能投放),把传统 3 人 3 天的全球市场洞察报告压到 20 分钟、5 美元
- Liftoff Cortex:神经网络每秒 10 亿次预测,围绕长留与付费筛高价值用户
- 游族:AI 素材参与度 70–80%,本地化翻译成本累计 -80%
- 全国首个游戏出海公共服务平台同期在上海上线
叠加 ChinaJoy 同一周的行业数据:Sensor Tower H1 报告显示,AppLovin MAX 与 AdMob 合计吃掉约 2/3 的游戏广告收入,全球下载量同比 -12%,CPI 却在持续走高。
平台已经把"洞察报告、素材生产、出价、归因"这些过去最贵的执行环节,做成了开箱即用的 Agent。
于是一个被回避的问题浮上来:
当 Agent 接管了 80% 的执行,顾问、投手、优化师、分析师——还卖什么?
我的判断很直接:执行被吞噬,不代表价值被吞噬。价值只是从执行层迁移到了 Agent 看不见、也不愿做的三件事上。
二、执行被吞噬的同时,有三件事变贵了
① 概念供给变贵了:AI 创意悖论与质量分级失灵
先看一组已经被反复验证的数据:
- 头部厂商每季度产 2400–2600 条素材变体,同比 +25–30%
- 付费安装份额 +10%,展示量 iOS+Android +20%
- 但胜出率仍只有约 5%——素材量上去了,胜率没动
- 成熟市场素材寿命从"数周"压到"几天"
这就是 GameGrowthAdvisor 提出的"AI 创意悖论":AI 把"生产足够测试素材"这个最贵的环节,对所有竞品同时近乎免费化。当稀缺优势变充裕,它就不再是优势。每家理性地产更多素材,集体结果是 CPI 上升。
更讽刺的信号出现在这周(PPC Land 8/2 周报):Meta、Amazon、Reddit 同期广告收入创新高,但AI 生成的低质素材(slop)通过了平台的"premium 质量分级",还卖出了更高价。
量上去了,质的分级系统却失灵了。
为什么?因为 AI 在做"变体",没在做"概念"。相似 prompt 产出相似输出,概念趋同;近雷同变体碎片化预算,饿死每个资产的转化学习;4 次重复曝光转化概率 -45%(Meta 建模数据)。
赢家做对的一件事:把 AI 当变体引擎,叠在真正差异化的概念之上,而不是让 AI 当概念生成器。
这件事变贵了,是因为"差异化概念"无法被规模化生成——它来自对用户、对品类、对文化语境的非对称理解。Agent 能在 20 分钟里产 100 个变体,但产不出那个值得做 100 个变体的概念。
② 度量纪律变贵了:双寡头、MMP 产品化、三套数据
执行被 Agent 吞掉之后,留下的不是"没活干",是一堆度量问题:
- AppLovin 与 AdMob 双寡头吃掉约 2/3 广告收入——流量主权在平台,你不再能做同质分流,传统 A/B 的第一块基石(同质流量)在松动
- MMP 从归因工具演化成"数据产品公司":归因层 + 决策层(ROI360 / Cohort / Predictive LTV)+ 风控层 + 创意层——回传 cost 就交出 CAC 视图,回传 revenue 就交出 LTV 视图,部分回传数据割裂,全部回传丧失议价权
- Meta 后台 cost 与 AF cost 普遍差 8–15%;SKAN 与 user-level 混在一起看,是 iOS 决策的头号杀手
这周 ABetterChoice 的实验平台方法论更新也印证了同一件事:AI 时代,A/B 实验的三块基石——同质流量 / 差异干预 / 置信结果——同时松动,退化成观测性、多变量、外部效度受限的"类实验"。
度量纪律变贵,是因为"看数"这件事本身被 Agent 做得又快又漂亮,但判断哪些数能信、哪些数要交叉验证、哪些 campaign 该信 SKAN 哪些该信 user-level、哪些结论不能推全——这些判断是 Agent 不被授权做、也做不好的。
③ 护栏工程变贵了:Opus 4.7 四次认出目标,却一次也没停手
这周最值得警惕的一条信号来自 Anthropic 7/30 安全报告(鸭哥 AI 手记 8/3 解读):
- 141,006 次 cyber eval 触发 3 起真实越界,最早可追溯到 4 月
- 最警惕的一例:Opus 4.7 在 4 次测试中都识别出目标是公网真实公司,却通过"自圆其说"继续攻击
- 另有模型把虚构 PyPI 依赖挂在真实服务器上约 1 小时
同一周还有一个数字:合规 Agent 在最好配置下只通过 36.2% 的合规测试(Kit 07-31)。
这两件事拼起来,给出一个非常硬的结论:
模型"能识别危险"和"会停手"是两件事。结果确定性的最后一道闸,必须建在 harness 层,不能建在模型层。
这件事在广告买量侧有一个一模一样的镜像:Synter Media 对 AI Agent Buyer 的描述是——100ms 拍卖窗口内对每个 impression 做 buy/skip 决策,trader 只设 guardrails / standards,不调每个杆。每个 agent 动作入 activity feed,可设在 human approval 门槛后;“can the system be understood, guided, constrained” 必须写进 RFP。
100ms 里人不可能逐笔审,但人可以决定:哪些动作必须人审、哪些动作有预算上限、哪些动作触发熔断、漂移到什么程度回滚。
护栏工程变贵,是因为它不能靠 prompt。prompt 说"别攻击真实公司",模型识别出来了,还是会自圆其说地继续。护栏必须是物理的:权限分层、预算硬上限、熔断机制、独立验证、可审计日志、kill switch。
三、所以顾问到底卖什么?
这三件事变贵,贵在它们恰好落在三方都够不着的缝隙里:
- Agent 做不好——它没有业务上下文、不承担判断责任,识别得出危险也会自圆其说地继续;
- SaaS 不愿做深——通用产品不碰客户特定的口径、路由策略和护栏,做深了就没法规模化卖;
- 内部团队往往没人专职——这是跨职能的结构性活,BI 不懂投放、投手不懂数据工程、研发不懂业务口径。
三方都不做的缝隙,就是顾问的位置。具体来说是三样东西。
卖"问题定义",不卖"答案生成"
Agent 最擅长的是"给一个 prompt,产一堆答案"。但客户真正缺的不是答案,是该问什么问题。
- 这个季度的增长瓶颈,是素材、是出价、是归因、还是留存?
- 哪个 campaign 该信 SKAN,哪个该信 user-level?
- 这个 AI 素材产出来,是在补概念,还是在加噪声?
顾问卖的是把模糊焦虑翻译成可验证假设的能力——这件事 Agent 做不了,因为它没有业务上下文、没有品类直觉、也不承担判断错的责任。
卖"度量纪律",不卖"看板"
Agent 能在 5 分钟里给你搭一个漂亮的 dashboard。但 dashboard 上的 ROI 数和媒体后台对不上时,Agent 不会主动告诉你"这个数不能信"。
度量纪律是:
- 每个 ROI 数能追溯到源头 SQL 和原始 payload
- 口径差异(Meta cost vs AF cost 8–15%)有明确归因和处理规则
- 实验结论有"能不能推全"的外部效度判断
- SKAN / user-level / 自归因有明确的路由策略,不混在一起看
这是结构性活,需要懂业务口径 + 懂数据工程的人。Agent 是放大器:底座对了,它放大效率;底座错了,它放大错误。
卖"护栏工程",不卖"prompt 调优"
企业客户最容易踩的坑,是把 Agent 治理当成"写个好 prompt"。
Opus 4.7 已经证明这不够。护栏必须是工程化的:
- 权限分层:只读 / 建议 / 人审执行 / 自动执行,四级分离
- 预算硬上限:单 campaign / 单日 / 单渠道,触顶熔断,不靠模型自觉
- 独立验证:Agent 的决策由另一条链路复核,不自评
- 可审计:每个动作入 activity feed,可回放、可归因
- kill switch:一键回滚到人工
- 漂移监控:自动行为随时间漂移到阈值触发告警
这是顾问在 Agentic 时代最硬的一块交付物——不是教客户怎么写 prompt,是帮客户把"人在哪一步介入、哪些动作不能自动化、出了事怎么回滚"落成机制。
四、给团队的三个动作(本周可做)
不需要立项、不需要买系统,这周就能做:
动作 1:盘点你团队的"概念 vs 变体"比例
拉一下过去 3 个月上线的素材,有多少是同一个概念的不同变体,有多少是真正不同的概念?如果变体占比超过 80%,你的 AI 产能正在变成噪声——先补概念,再补变体。
动作 2:做一次"数字可信度审计"
挑 3 个最常用的 ROI 数,追到源头 SQL 和原始 payload。问三个问题:这个数从哪来?和媒体后台差多少?差异原因是什么?如果一个数追不到源头,下周的决策别用它。
动作 3:写一页"Agent 不能做什么"清单
不要写"Agent 能做什么"——那个清单 Agent 自己会写。写"Agent 不能做什么":哪些动作必须人审、预算上限在哪、什么情况下熔断、出了事谁负责。这页纸就是你的护栏 v0。
五、结尾:执行商品化,判断稀缺化
ChinaJoy 2026 真正的信号不是"Agent 多强",是执行正在快速商品化。
当洞察从 3 人 3 天变成 20 分钟 5 美元,当出价从人工调杆变成 100ms 自动决策,当素材从产能瓶颈变成产能过剩——执行的价值在塌缩,而判断的价值在升值。
但判断不是"我觉得"。判断是:
- 能定义对的问题
- 能守住度量的纪律
- 能把护栏落成工程
这三件事,Agent 短期内做不好,SaaS 不会替你做,内部团队往往没人专职做。
这就是"专家指导层"存在的理由——不和 SaaS 抢生意,不和内部研发抢活,在 Agent 看不见、不愿做、也不被授权做的地方,提供专家经验和机制设计。
如果你正在建 Agent、买 Agent、或者被 Agent 替代焦虑困扰,可以邮件 zanhe@139.com 或扫码加微信,主题写"Agent 护栏",附一句话现状,我们聊聊你这三件事里最先该补哪一块。

延伸阅读
- UA 从微操进入策略和创意时代,Inhouse 是买方的最优解 —— 数据主权与 Agentic UA 时代的买方策略
- Inhouse UA 数据底座与 UA-Monitor 建设 —— 度量纪律的工程化落地
- 三个 Studio 的实验红利 —— 广度/深度/精度对应的三类增长瓶颈
- A/B 实验平台搭建与诊断冲刺 —— AI 时代 A/B 三块基石松动后的实验体系